
AT_ahc056_a.[AHC056A] Grid Turing Robot
NOI/NOI+/CTSC
通过率:0%


AC君温馨提醒
该题目为【atcoder】题库的题目,您提交的代码将被提交至atcoder进行远程评测,并由ACGO抓取测评结果后进行展示。由于远程测评的测评机由其他平台提供,我们无法保证该服务的稳定性,若提交后无反应,请等待一段时间后再进行重试。
题目描述
$ N\times N $ マスの盤面がある。 左上のマスの座標を $ (0, 0) $ とし、下方向に $ i $ 、右方向に $ j $ 進んだ位置の座標を $ (i, j) $ とする。 $ N\times N $ マスの外周は壁で囲まれており、また、隣接するマスの間にも壁が存在する場合がある。
各マスには色を塗ることができる。 使用する色の総数を $ C $ とし、各色は整数 $ 0,1,\ldots,C-1 $ で表す。 初期状態の盤面の色は自由に設定してよい。
ロボットは、内部状態 を表す変数を1つ持つ。 この内部状態は整数 $ 0,1,\ldots,Q-1 $ のいずれかの値をとる。 取りうる状態の総数 $ Q $ は自由に設定してよい。 内部状態の初期値は $ 0 $ である。
ロボットは現在位置の色 $ c $ と内部状態 $ q $ に基づいて、次の行動を決定し、以下の3つの操作を同時に行う。
- 現在位置の色を $ A(c, q) $ に塗り替える(現在と同じ色に塗り替えてもよい)。
- 内部状態を $ S(c, q) $ に更新する(現在と同じ内部状態に更新してもよい)。
- $ D(c, q) $ の方向に移動する(上・下・左・右・移動しない)。移動先との間に壁がある場合、ロボットは移動できずその場に留まる。
ここで、 $ A, S, D $ はそれぞれ 遷移規則 を表す関数である。 遷移規則は動作開始前に設計し、動作中に変更することはできない。 また、ロボットの行動は現在位置そのものには依存せず、現在位置の色と内部状態のみによって決定される。
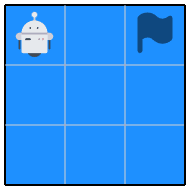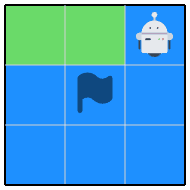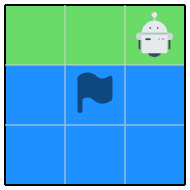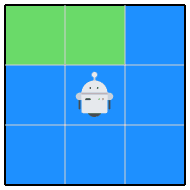
ロボットの動作例
上図の例ではまず、 $ 3\times 3 $ の盤面が青色に塗られた状態で位置 $ (0, 0) $ から動作を開始し、以下の3つの遷移規則に従って動作する。
- $ A(青,0)=緑 $ , $ S(青,0)=0 $ , $ D(青,0)=右 $
- $ A(緑,0)=青 $ , $ S(緑,0)=1 $ , $ D(緑,0)=左 $
- $ A(緑,1)=緑 $ , $ S(緑,1)=1 $ , $ D(緑,1)=下 $
最初の3ステップでは遷移規則 1 が繰り返し適用され、緑色に塗り替えつつ右へ進む。3ステップ目では壁にぶつかるため、移動できずその場にとどまる。 4ステップ目は現在位置が緑色のため、遷移規則 2 が適用され、青色に塗り替えながら左に移動し、内部状態が $ 1 $ へと切り替わる。 最後に5ステップ目では、現在位置が緑色かつ内部状態が $ 1 $ のため、遷移規則 3 が適用され、下に移動する。
$ K $ 箇所の目的地の列 $ (x_0,y_0),(x_1,y_1),\ldots,(x_{K-1},y_{K-1}) $ と、ステップ数の上限 $ T $ が与えられる。 ロボットは $ (x_0,y_0) $ のマスからスタートし、 $ T $ ステップ以内に、指定された順にすべての目的地を訪れることを目指す。
ここで、目的地が $ (x_i,y_i) $ のとき、まだ順番が来ていない $ (x_j,y_j) $ ( $ j>i $ )のマスを先に訪れても、訪問したことにはならない。 実際に $ (x_j,y_j) $ が次の目的地になった時点で、その目的地に改めて到達しなければならない。
すべての目的地を順に訪問できるように、盤面の初期色の配置とロボットの遷移規則を設計せよ。
输入格式
入力は以下の形式で標準入力から与えられる。
$ N $ $ K $ $ T $ $ v_{0,0} $ $ \cdots $ $ v_{0,N-2} $ $ \vdots $ $ v_{N-1,0} $ $ \cdots $ $ v_{N-1,N-2} $ $ h_{0,0} $ $ \cdots $ $ h_{0,N-1} $ $ \vdots $ $ h_{N-2,0} $ $ \cdots $ $ h_{N-2,N-1} $ $ x_0 $ $ y_0 $ $ \vdots $ $ x_{K-1} $ $ y_{K-1} $
- 盤面の大きさ $ N $ は $ 10\leq N\leq 20 $ を満たす。
- 目的地の個数 $ K $ は $ N\leq K\leq N^2 $ を満たす。
- すべての目的地を順に訪れる最小移動回数を $ X $ とすると、ステップ数の上限 $ T $ は $ X\leq T\leq 2X $ を満たす。
- $ v_{i,0} \cdots v_{i,N-2} $ は長さ $ N-1 $ の
01からなる文字列であり、 $ j $ 文字目 $ v_{i,j} $ はマス $ (i, j) $ とマス $ (i, j+1) $ の間に壁がある(1)かない(0)かを表す。 - $ h_{i,0} \cdots h_{i,N-1} $ は長さ $ N $ の
01からなる文字列であり、 $ j $ 文字目 $ h_{i,j} $ はマス $ (i, j) $ とマス $ (i+1, j) $ の間に壁がある(1)かない(0)かを表す。 - 全てのマスは互いに到達可能であることが保証されている。
- $ (x_k, y_k) $ は $ k $ 番目の目的地の座標を表し、 $ 0\leq x_k,y_k\leq N-1 $ を満たす。すべての目的地は相異なる。
输出格式
以下の形式で標準出力に出力せよ。
$ C $ $ Q $ $ M $ $ s_{0,0} $ $ \cdots $ $ s_{0,N-1} $ $ \vdots $ $ s_{N-1,0} $ $ \cdots $ $ s_{N-1,N-1} $ $ c_0 $ $ q_0 $ $ A(c_0,q_0) $ $ S(c_0,q_0) $ $ D(c_0,q_0) $ $ \vdots $ $ c_{M-1} $ $ q_{M-1} $ $ A(c_{M-1},q_{M-1}) $ $ S(c_{M-1},q_{M-1}) $ $ D(c_{M-1},q_{M-1}) $
- $ C $ は使用する色数であり、 $ 1 \le C \le N^4 $ を満たす必要がある。
- $ Q $ は使用する内部状態数であり、 $ 1 \le Q \le N^4 $ を満たす必要がある。
- $ M $ は出力する遷移規則の行数であり、 $ 0 \le M \le T $ を満たす必要がある。
- $ s_{i,j} $ は初期状態におけるマス $ (i,j) $ の色であり、 $ 0 \le s_{i,j} \le C-1 $ を満たす必要がある。
- 各行 $ c_i $ $ q_i $ $ A(c_i,q_i) $ $ S(c_i,q_i) $ $ D(c_i,q_i) $ は、現在位置の色が $ c_i $ 、内部状態が $ q_i $ のときに適用する遷移規則を表す。
- $ 0\leq c_i\leq C-1 $ 、 $ 0\leq q_i\leq Q-1 $ を満たす必要があり、同じ $ (c_i,q_i) $ の組は高々一度しか出現してはならない。
- 塗り替える色 $ A(c_i,q_i) $ は $ 0 \le A(c_i,q_i) \le C-1 $ を満たす必要がある。
- 新しい内部状態 $ S(c_i,q_i) $ は $ 0 \le S(c_i,q_i) \le Q-1 $ を満たす必要がある。
- 移動方向 $ D(c_i,q_i) $ は以下の5文字のいずれかで表す。
- 上:
U - 下:
D - 左:
L - 右:
R - 移動しない:
S
- 上:
$ C\times Q $ は非常に大きくなり得るため、すべての組 $ (c,q) $ に対する遷移規則を出力する必要はない。 シミュレーション中に実際に遭遇する可能性のある組に対する遷移規則のみを出力すればよい。 最大で $ T $ ステップであるため、高々 $ T $ 行の遷移規則を出力すれば十分である。 ただし、実行中に遭遇した $ (c,q) $ に対する遷移規則が出力中に存在しない場合、その時点でロボットの行動は打ち切られる。
输入输出样例
输入#1
3 3 6
00
00
00
000
000
0 0
0 2
1 1
输出#1
2 2 3
0 0 0
0 0 0
0 0 0
0 0 1 0 R
1 0 0 1 L
1 1 1 1 D
说明/提示
得点
使用する色数を $ C $ 、状態数を $ Q $ 、ステップ数の上限 $ T $ 以内に訪問できた目的地の数を $ V $ とする。 このとき、以下の絶対スコアが得られる。
- $ V=K $ の場合、 $ C+Q $
- $ V<K $ の場合、 $ 2N^4 + (K-V)\times N^2 $
絶対スコアは小さければ小さいほど良い。
各テストケース毎に、 $ \mathrm{round}(10^9\times \frac{全参加者中の最小絶対スコア}{自身の絶対スコア}) $ の相対評価スコアが得られ、その和が提出の得点となる。
最終順位はコンテスト終了後に実施されるより多くの入力に対するシステムテストにおける得点で決定される。 暫定テスト、システムテストともに、一部のテストケースで不正な出力や制限時間超過をした場合、そのテストケースの相対評価スコアは0点となり、そのテストケースにおいては「全参加者中の最小絶対スコア」の計算から除外される。 システムテストは CE 以外の結果を得た一番最後の提出に対してのみ行われるため、最終的に提出する解答を間違えないよう注意せよ。
テストケース数
- 暫定テスト: 50個
- システムテスト: 2000個、コンテスト終了後に seeds.txt (sha256=c7a6f9526da67d83d1f8fed006e1b8f5edc8e4134444cf954e400a4dcd8bd130) を公開
相対評価システムについて
暫定テスト、システムテストともに、CE 以外の結果を得た一番最後の提出のみが順位表に反映される。 相対評価スコアの計算に用いられる各テストケース毎の全参加者中の最小絶対スコアの算出においても、順位表に反映されている最終提出のみが用いられる。
順位表に表示されているスコアは相対評価スコアであり、新規提出があるたびに、相対評価スコアが再計算される。 一方、提出一覧から確認出来る各提出のスコアは各テストケース毎の絶対スコアをそのまま足し合わせたものであり、相対評価スコアは表示されない。 最新以外の提出の、現在の順位表における相対評価スコアを知るためには、再提出が必要である。 不正な出力や制限時間超過をした場合、提出一覧から確認出来るスコアは0となるが、順位表には正解したテストケースに対する相対スコアの和が表示されている。
実行時間について
実行時間には多少のブレが生じます。 また、システムテストでは同時に大量の実行を行うため、暫定テストに比べて数%程度実行時間が伸びる現象が確認されています。 そのため、実行時間制限ギリギリの提出がシステムテストでTLEとなる可能性がありま す。 プログラム内で時間を計測して処理を打ち切るか、実行時間に余裕を持たせるようお願いします。
入力生成方法
$ L $ 以上 $ U $ 以下の整数値を一様ランダムに生成する関数を $ \mathrm{rand}(L, U) $ とする。
盤面の生成
マスの角にあたる点を「頂点」と呼ぶことにする。
$ N=\mathrm{rand}(10,20) $ により盤面サイズを決定する。壁の面数を $ W=\mathrm{rand}(0,N-1) $ により決定し、マス間に壁がない状態から開始して、以下を $ W $ 回繰り返す。
頂点のうち、既存の壁に接していないものから一様ランダムに1つを選び、その頂点から上下左右のいずれかの方向を選んで、他の壁に接するまで壁を伸ばす。
目的地の生成
$ K=\mathrm{rand}(N,N^2) $ により目的地の個数を決定する。 $ N^2 $ 個のマスを一様ランダムな順に並び替え、その最初の $ K $ 個を目的地の列として選択する。
$ T $ の生成
すべての目的地を順に訪れる最小移動回数 $ X $ を計算し、 $ T=\mathrm{rand}(X,2X) $ によりステップ数の上限 $ T $ を決定する。
サンプルプログラム(Python)
# 入力
N, K, T = map(int, input().split())
v = [input().strip() for _ in range(N)]
h = [input().strip() for _ in range(N - 1)]
targets = [tuple(map(int, input().split())) for _ in range(K)]

# 移動可能か判定する関数
DIJ = {'U': (-1, 0), 'D': (1, 0), 'L': (0, -1), 'R': (0, 1)}
def can_move(i, j, d):
   if d == 'U':
       if i == 0: return False
       return h[i - 1][j] == '0'
   elif d == 'D':
       if i == N - 1: return False
       return h[i][j] == '0'
   elif d == 'L':
       if j == 0: return False
       return v[i][j - 1] == '0'
   elif d == 'R':
       if j == N - 1: return False
       return v[i][j] == '0'
   return False

# --- 戦略 ---
# 内部状態は常に0とする。
# 各マスに異なる初期色を塗り、色の塗り替えは行わず、色で現在位置を表現する。
# 目的地1までのマンハッタン距離が短くなる方向に動し、そのような方向が無いなら停止。
C = N * N
Q = 1
s = [[0] * N for _ in range(N)]
for i in range(N):
    for j in range(N):
         s[i][j] = i * N + j
rules = []
i, j = targets[0] # 現在位置
gi, gj = targets[1] # 最初の目的地
for t in range(T):
   d = 'S'
   if i > gi and can_move(i, j, 'U'):
       d = 'U'
   elif i < gi and can_move(i, j, 'D'):
       d = 'D'
   elif j > gj and can_move(i, j, 'L'):
       d = 'L'
   elif j < gj and can_move(i, j, 'R'):
       d = 'R'
   if d == 'S':
       break
   rules.append((s[i][j], 0, s[i][j], 0, d))
   di, dj = DIJ[d]
   i, j = i + di, j + dj

# 出力
print(C, Q, len(rules))
for r in range(N):
   print(' '.join(map(str, s[r])))
for c, q, A, S, D in rules:
   print(c, q, A, S, D)
ツール(入力ジェネレータ・ビジュアライザ)
- Web版: ローカル版より高性能でアニメーション表示が可能です。
- ローカル版: 使用するにはRust言語のコンパイル環境をご用意下さい。
- Windows用のコンパイル済みバイナリ: Rust言語の環境構築が面倒な方は代わりにこちらをご利用下さい。
コンテスト期間中に、ビジュアライズ結果の共有や、解法・考察に関する言及は禁止されています。ご注意下さい。
Sample Explanation 1
これは、問題文中のロボットの動作例に対応する入出力である。説明用のものであり、入力の制約は満たしていない。
输入解题思路,AI测评打分。不知道怎么写?